




SpaceXAI merilis Grok 4.7, dan penilaian independen menempatkannya di posisi keempat di antara lab AI frontier teratas.
Artificial Analysis, sebuah perusahaan benchmarking independen, memberi skor model ini 46 pada Intelligence Index, 2 poin di atas Grok 4.6. Claude Fable 5.1, GPT-6 Astra, dan Claude Opus 5 semuanya masih berada di peringkat lebih tinggi.
Grok 4.7 Dorong SpaceXAI ke Empat Besar Lab AI
Elon Musk pernah mengatakan sebelum peluncuran bahwa model ini akan berjalan dengan basis 2,1 triliun parameter dan mampu melampaui semua model yang ada saat ini. Dia juga menuturkan kalau pelatihan model ini ikut menggunakan data milik perusahaan SpaceX.
Ikuti kami di X untuk dapatkan berita terbaru secara langsung
Grok 4.7 is here.
It's a notable improvement over Grok 4.6 at the same price and speed. pic.twitter.com/H3OTBbXyvO
— SpaceXAI (@SpaceXAI) September 21, 2026
Disponsori
Disponsori
Tapi, bagaimana sebenarnya performa Grok 4.7? Pada AA-Briefcase, sebuah benchmark Artificial Analysis untuk tugas-tugas kerja profesional realistis, Grok 4.7 meraih skor 1.657 Elo. Ini berarti naik 111 poin dari Grok 4.6 serta membuat level modelnya hampir menyamai Claude Opus 5.
Pada GDPval-AA, model ini mencapai skor 1.695 Elo, unggul 90 poin dari pendahulunya. Hasil untuk coding juga bergerak ke arah yang sama.
Dipadukan dengan Grok Build, agen coding miliknya sendiri, Grok 4.7 mendapat skor 56 pada Coding Agent Index. Angka ini sembilan poin lebih tinggi dibanding Grok 4.6.
Model ini sudah melampaui GPT-5.6 Sol dan saat ini hanya berada di bawah Claude Fable 5.1 dari Anthropic, GPT-6 Astra, dan Opus 5.
“Grok 4.7 mendapat skor 46 di Artificial Analysis Intelligence Index hingga membawa SpaceXAI ke empat besar lab AI. Performa Coding Agent Index juga telah meningkat, bahkan melewati GPT-5.6 Sol,” demikian isi unggahan tersebut.
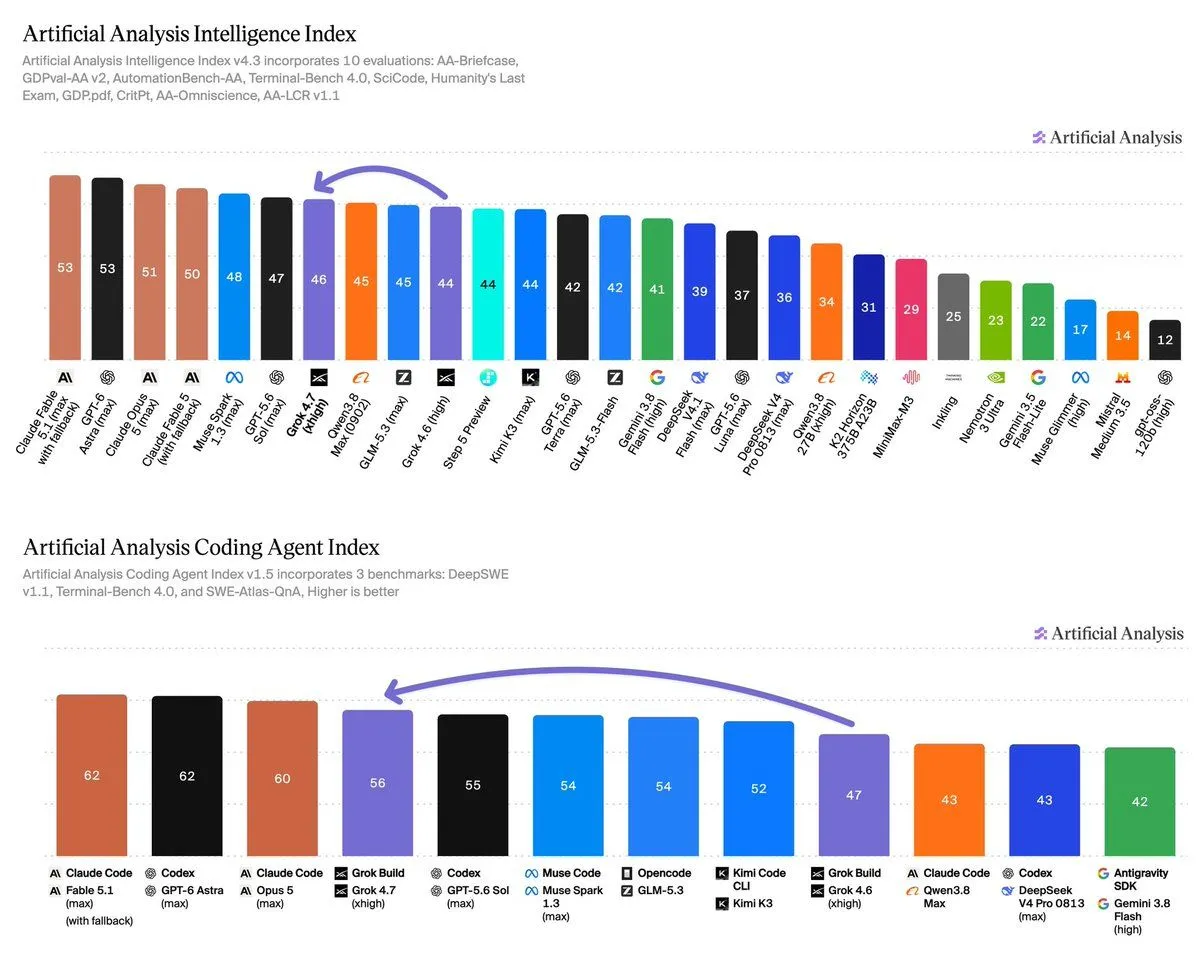
Bagaimana Performa Grok 4.7 | Sumber: X/Artificial Analysis
Di sisi lain, model ini nyaris tidak bergerak. Grok 4.7 naik 4,5 poin persentase pada Terminal-Bench 4.0 dan 3 poin pada GDP.pdf. Namun, skor pada tes AA-LCR dan AutomationBench-AA justru menurun. Grok 4.5 sebelumnya memuncaki AutomationBench pada bulan Juli, yang menguatkan klaim Musk bahwa modelnya setara dengan Claude Opus.
Kenaikan Kinerja Disertai Tagihan Token
Harga tetap tidak berubah. Grok 4.7 masih dikenakan biaya US$2 per sejuta input token dan US$6 per sejuta output token. Cache hits tetap didiskon menjadi US$0,50, dan context window 500.000 token tetap sama sejak Grok 4.6.
Tetapi, model ini kini melakukan pekerjaan lebih banyak untuk setiap jawabannya. Artificial Analysis memperkirakan sekitar 81.000 output token per tugas Index, jauh dibandingkan 36.000 pada Grok 4.6 dan 27.000 pada GPT-6 Astra. Karena itu, harga per token yang stabil tetap menghasilkan tagihan per tugas yang lebih tinggi.
Konsumsi token sebesar ini berdampak pada divisi yang sudah melaporkan kerugian sebesar US$1,26 miliar. Sementara itu, Musk menuturkan pada 14 September bahwa pelatihan Grok 4.8 akan selesai dalam waktu seminggu.
Ia juga memperkirakan Grok 5 akan menjadi model yang mencapai artificial general intelligence. Rilis berikutnya akan menjadi ujian apakah SpaceXAI bisa naik peringkat tanpa membakar lebih banyak daya komputasi.